Was braucht es, damit Machine Learning in Umweltbehörden praktisch nutzbar wird?
BMFTR-gefördertes Projekt Simplex4Learning unter Leitung von Disy entwickelt praxisnahen Ansatz

Umweltbehörden haben immer größere Datenbestände – doch zwischen vorhandenen Daten und einer nutzbaren Machine Learning-Anwendung liegt ein weiter Weg. Im Forschungsprojekt Simplex4Learning haben wir gemeinsam mit unseren Projekt- und Anwendungspartnern untersucht, wie sich diese Lücke schließen lässt. Die Ergebnisse zeigen: Es braucht mehr als ein gutes ML-Modell. Entscheidend ist das Zusammenspiel von Datenbasis, Automatisierung, Fachwissen, Nachvollziehbarkeit und Wiederverwendung.
Messstationen, Geodaten, Wetterdaten, Fernerkundung oder Fachverfahren: Für viele Aufgaben in Umweltbehörden stehen heute umfangreiche Daten zur Verfügung. Gleichzeitig können Machine Learning-Verfahren dabei helfen, Muster in diesen Daten zu erkennen, Zusammenhänge zu untersuchen oder Prognosen zu erstellen. In der Praxis stellt sich aber schnell die Frage: Wie kommt Machine Learning aus dem Data Science-Umfeld in die fachliche Anwendung?
Genau damit haben wir uns im BMFTR-Forschungsprojekt Simplex4Learning beschäftigt. Gemeinsam mit der Simplex4Data GmbH und der Hochschule für Technik und Wirtschaft Berlin sowie den Anwendungspartnern Landesanstalt für Umwelt Baden-Württemberg (LUBW BW), Landesamt für Natur, Umwelt und Klima Nordrhein-Westfalen (LANUK NRW) und dem Landesbetrieb Forst Brandenburg (LFB) haben wir methodische und technologische Ansätze entwickelt und an konkreten Umweltfragestellungen erprobt. Dabei wurden mehr als 100 mögliche Anwendungsideen für Machine Learning in der Umweltverwaltung identifiziert.
Aus drei Jahren Forschung nehmen wir vor allem fünf Erkenntnisse mit.
 Machine Learning beginnt nicht beim Modell, sondern bei den Daten
Damit Machine Learning sinnvoll eingesetzt werden kann, müssen die benötigten Daten zunächst verfügbar, miteinander kombinierbar und für die Analyse geeignet sein. Gerade in der Umweltverwaltung ist das anspruchsvoll: Daten liegen in unterschiedlichen Formaten und Systemen vor und unterscheiden sich räumlich, zeitlich und fachlich.
Simplex4Learning hat deshalb nicht nur ML-Verfahren betrachtet. Ein wesentlicher Bestandteil des Ansatzes war ein harmonisierter Datenpool, in dem unterschiedliche Umwelt- und ergänzende Daten zusammengeführt und für ML-Verfahren bereitgestellt werden können.
Wie wichtig diese Verbindung ist, zeigte sich beispielsweise beim Anwendungsfall des LFB. Für die Vorhersage der Pheromonfallenfänge für den Nachtfalter Nonne wurden Fachdaten mit regionalisierten Wetterdaten kombiniert. Allein die Fachdaten umfassten rund 260.000 Beobachtungen.
Die Erkenntnis daraus: Wer Machine Learning in der Verwaltung breiter einsetzen möchte, muss Datenbereitstellung und ML gemeinsam denken.
 Der Zugang zu Machine Learning muss zur Anwenderrolle passen
Eine weitere zentrale Frage im Projekt war, wer eigentlich mit Machine Learning arbeiten soll.
Denn Fachanwender:in ist nicht gleich Fachanwender:in. Wer ein vorhandenes Modell für eine fachliche Analyse nutzt, braucht andere Kenntnisse und Funktionen als jemand, der ein Modell trainiert oder neue ML-Verfahren entwickelt.
Daher unterscheiden wir verschiedene Rollen – vom Explorer, der vorhandene Modelle für fachliche Fragestellungen nutzt, über Analyst:innen bis hin zu Data Scientists, die ML-Architekturen und Modelle entwickeln.
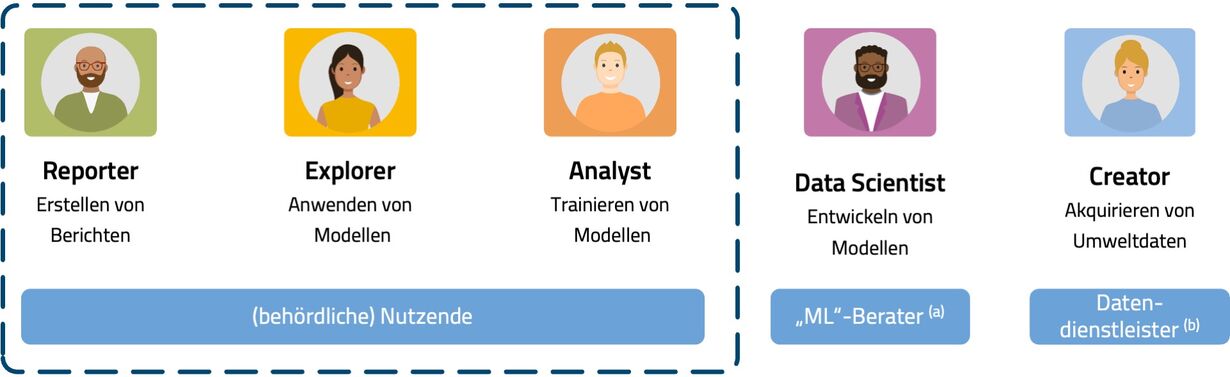
Das verändert auch die Perspektive auf KI-Kompetenz: Nicht alle Beschäftigten müssen selbst ML-Modelle entwickeln können. Vielmehr brauchen sie Werkzeuge, die zu ihren Aufgaben und ihrem jeweiligen Kompetenzniveau passen.
 Automatisierung kann die Einstiegshürde senken
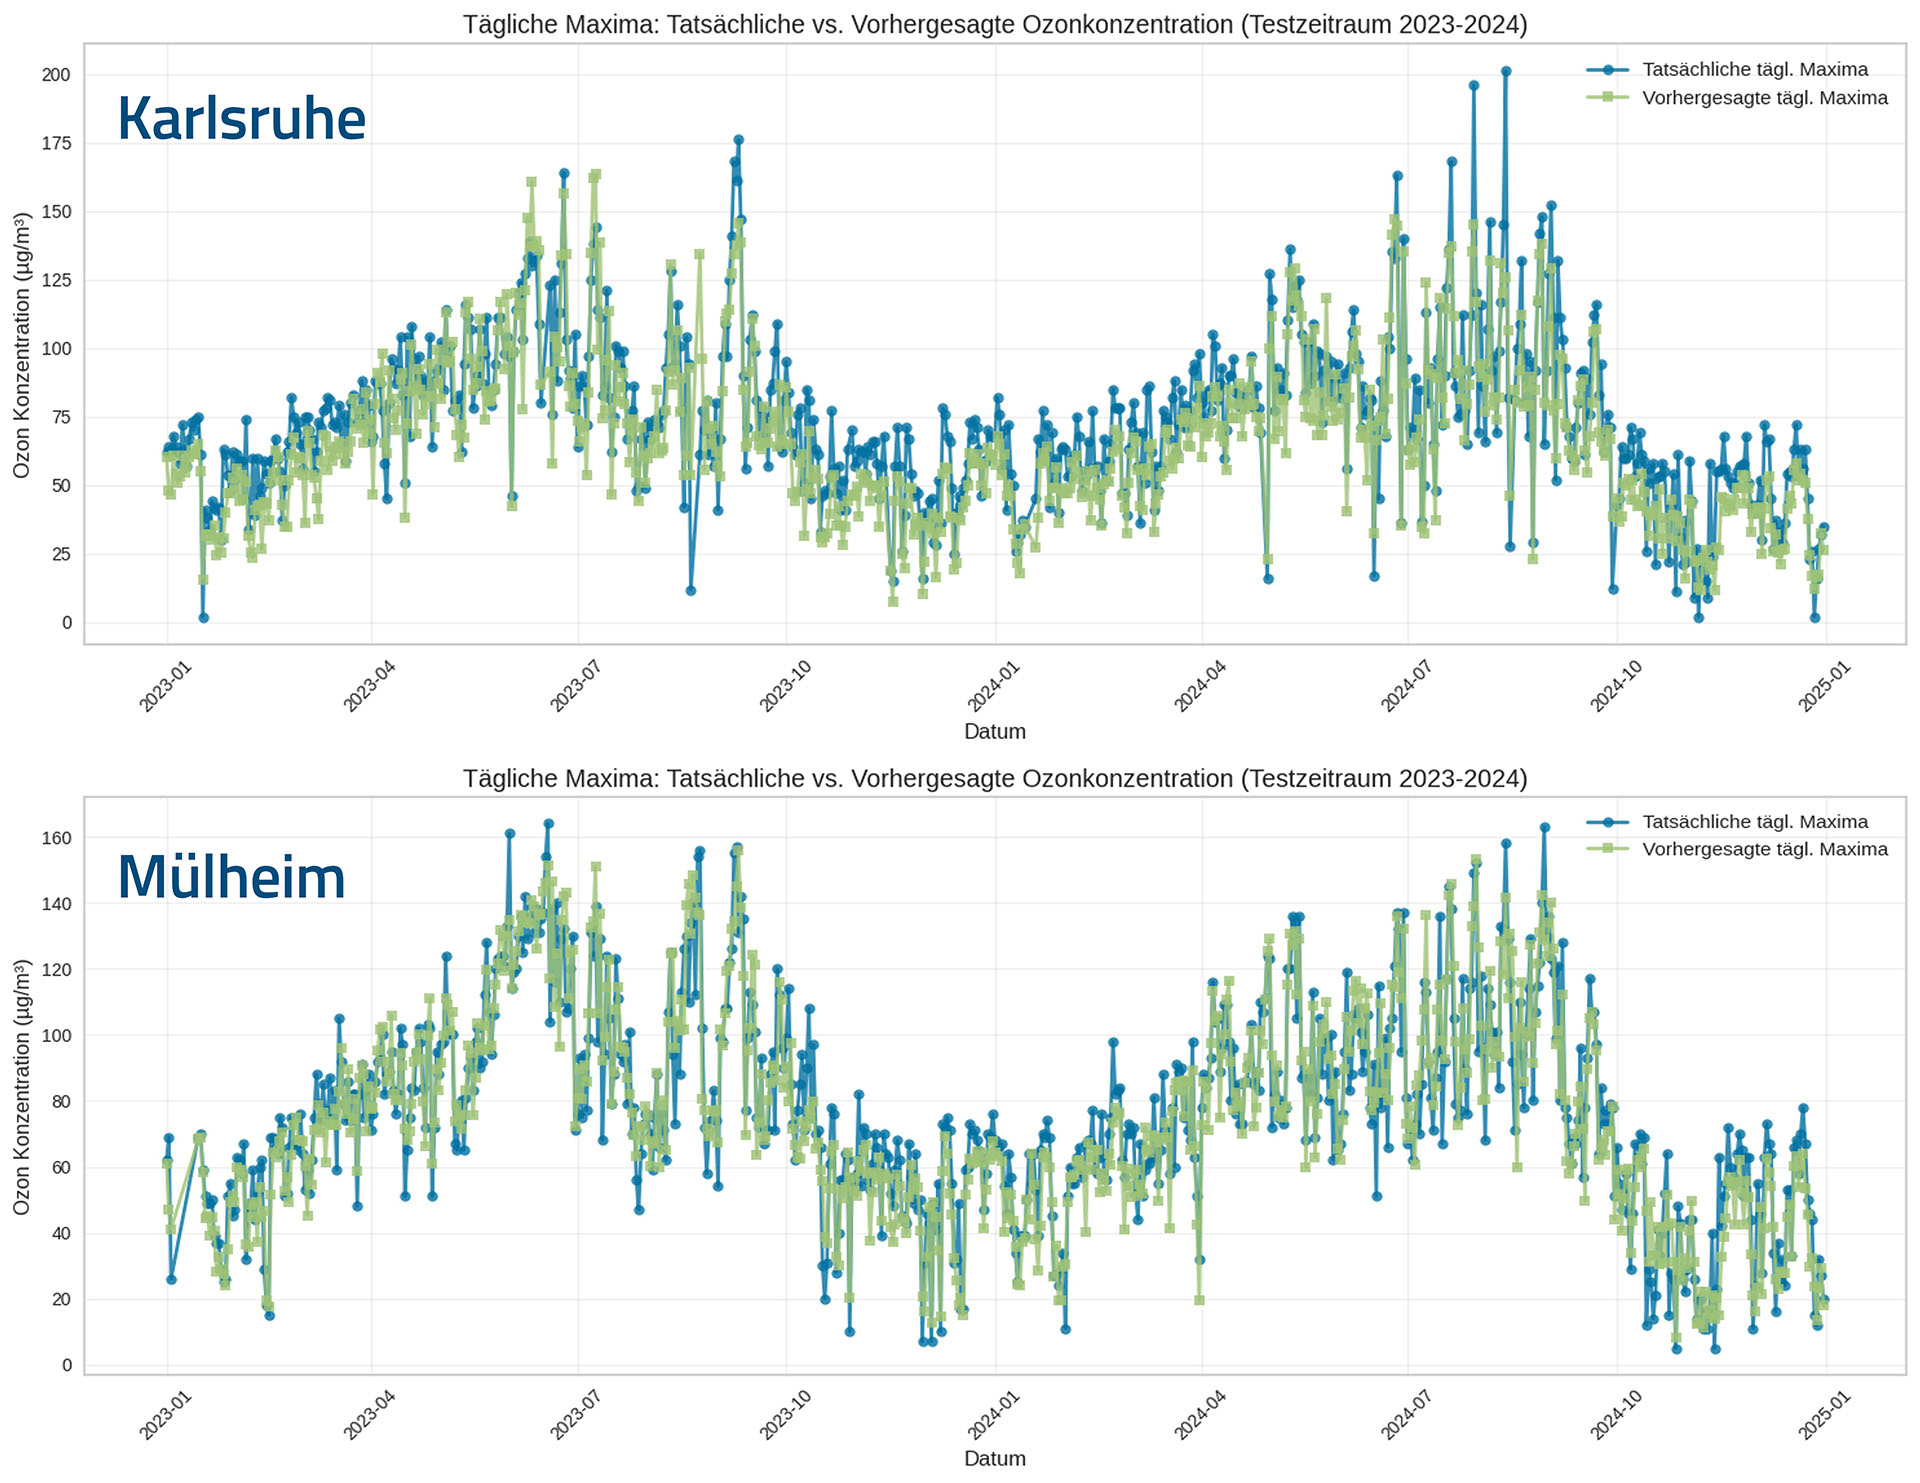
Hier setzt AutoML – automatisiertes Machine Learning – an. Wiederkehrende Schritte bei der Erstellung und Bewertung von Modellen können automatisiert und als standardisierte Workflows bereitgestellt werden.
Im Projekt wurde beispielsweise anhand von Beispieldaten aus Baden-Württemberg ein Workflow zur Vorhersage der Ozonkonzentration entwickelt. Statt einen kompletten ML-Prozess programmieren zu müssen, werden Datenquelle und Zielvariable konfiguriert. Der Workflow konnte anschließend mit Daten aus Nordrhein-Westfalen eingesetzt werden, ohne Plattformarchitektur, Modellkonfiguration oder Modellierungslogik anzupassen. Das ist insbesondere für die Wiederverwendung interessant: Nicht jede neue Fragestellung muss zwangsläufig bei null beginnen.
Gleichzeitig hat das Projekt gezeigt, dass Wiederverwendung differenziert betrachtet werden muss. Dass ein Workflow technisch auf neue Daten übertragen werden kann, bedeutet nicht automatisch, dass auch ein bereits trainiertes Modell für eine andere Region oder einen anderen Datenbestand geeignet ist. Genau das muss fachlich und methodisch geprüft werden.
 Ein ML-Ergebnis muss nachvollziehbar sein
Gerade in der Verwaltung reicht es nicht aus, dass ein Modell einen Wert oder eine Prognose liefert. Fachanwender:innen müssen das Ergebnis bewerten und einordnen können.
Deshalb wurden in Simplex4Learning auch Verfahren der Explainable AI (XAI) untersucht. Sie können beispielsweise sichtbar machen, welche Merkmale besonders stark zu einer Modellvorhersage beigetragen haben.
Beim Forst-Anwendungsfall wurden solche Verfahren genutzt, um Zusammenhänge zwischen Standort- und Wetterfaktoren und den prognostizierten Pheromonfallenfängen von Forstschädlingen zu untersuchen.
Die Forschung hat aber auch Grenzen gezeigt: Die im Projekt untersuchten XAI-Verfahren waren unter den gegebenen technischen Bedingungen nur eingeschränkt praktikabel. Wie sich Erklärbarkeit effizient in ML-Prozesse integrieren lässt, bleibt deshalb ein wichtiges Entwicklungsfeld.
 Machine Learning muss Teil des Analyseprozesses werden
Am Ende entscheidet nicht allein die Leistungsfähigkeit eines ML-Modells darüber, ob es in der Praxis genutzt wird. Entscheidend ist auch, wie gut sich ML in bestehende Daten- und Analyseprozesse integrieren lässt.
Im Projekt wurde dafür eine prototypische Plattformarchitektur entwickelt, die unterschiedliche Bausteine zusammenführt: Datenharmonisierung und -haltung, AutoML, Modellverwaltung und -wiederverwendung sowie Explainable AI. disy Cadenza wurde exemplarisch als fachanwenderorientierte Oberfläche angebunden.

Damit lässt sich eine zentrale Idee von Simplex4Learning veranschaulichen: Fachanwender:innen sollen nicht zwischen Datenmanagement, ML-Werkzeugen und Datenanalyse hin- und herspringen müssen. Perspektivisch sollen ML-Verfahren dort zugänglich werden, wo sie ihre Daten ohnehin untersuchen und Ergebnisse weiterverwenden.
Und dann kam generative KI
Während der dreijährigen Projektlaufzeit hat sich die KI-Landschaft rasant weiterentwickelt. Insbesondere große Sprachmodelle haben neue Anwendungsmöglichkeiten eröffnet, die zu Beginn von Simplex4Learning noch nicht im Mittelpunkt standen.
Beim LANUK Nordrhein-Westfalen wurde deshalb zusätzlich untersucht, wie Large Language Models die Erstellung strukturierter Berichte für den Klima-Atlas unterstützen können. Ziel war es, einen bislang aufwendigen manuellen Prozess stärker zu automatisieren, ohne fachliche Qualität und Vertrauenswürdigkeit aus dem Blick zu verlieren.
Der Anwendungsfall unterscheidet sich technologisch von den klassischen ML-Szenarien im Projekt. Er zeigt aber, wie schnell sich das Spektrum möglicher KI-Anwendungen in der Umweltverwaltung erweitert.
Was wir aus Simplex4Learning mitnehmen
„ Entscheidend ist, Daten, ML-Methoden und geeignete Werkzeuge so zusammenzubringen, dass ML für konkrete fachliche Fragestellungen nutzbar wird. Simplex4Learning hat uns wichtige Erkenntnisse darüber geliefert, welche technischen und methodischen Voraussetzungen dafür notwendig sind ”
Dr. Andreas Abecker, Leiter Forschung und Innovation bei Disy
Für uns bei Disy ist genau das eine wesentliche Erkenntnis aus dem Forschungsprojekt. Wir haben Erfahrungen und Werkzeuge aufgebaut, um einzelne Machine Learning-Vorhaben in Umweltverwaltungen zu unterstützen – und zugleich untersucht, welche Voraussetzungen für einen systematischeren Einsatz von ML innerhalb einer Organisation notwendig sind.
Die entwickelten Bausteine bieten dafür Anknüpfungspunkte für weitere Forschung und konkrete Anwendungsvorhaben. Gleichzeitig bleiben Fragen offen – etwa zur effizienten Erklärbarkeit von Modellen oder dazu, unter welchen Bedingungen Modelle und ML-Workflows tatsächlich wiederverwendet werden können.
Das Forschungsprojekt Simplex4Learning ist damit beendet. Die Frage, wie Machine Learning für Fachanwender:innen möglichst einfach, nachvollziehbar und sinnvoll Teil der Datenanalyse werden kann, begleitet uns weiter.
Rahmendaten zum BMBF-Forschungsprojekt Simplex4Learning
- Projekttitel: Intelligente Umweltdatenanalyse durch automatisiertes maschinelles Lernen für Fachanwender (Simplex4Learning)
- Fördergeber: Bundesministerium für Bildung, Forschung, Technologie und Raumfahrt (BMFTR)
- Fördermaßnahme: KMU-innovativ IKT
- Projektlaufzeit: 01.10.2023 - 31.08.2026
- Projektkonsortium: Disy Informationssysteme GmbH, Simplex4Data GmbH, Hochschule für Technik und Wirtschaft Berlin
- Assoziierte Anwendungspartner: Landesamt für Natur-, Umwelt- und Klima Nordrhein-Westfalen (LANUK), Landesanstalt für Umwelt Baden-Württemberg (LUBW), Landesbetrieb Forst Brandenburg (LFB)